全站看板
选择 Harness
选择 Benchmark
查看公开参考示例


我们怎么评分的
运行工具 + 模型能力看板
每 60 秒自动刷新选题跑题区
需要参与跑题时,从这里认领格子并开始运行
雷达天梯 每一次蹬踏,都让雷达测试得更准。致敬每一位贡献算力的蹬友 🫡
🏆 首届冠军 Crosner(@ymcui)· 精彩冲线
🏆 第二届冠军 雷达站长 · 15 万刀冲线回放
📜 第二届 15 万刀夺旗赛 · 前台直播记录
加载直播记录中……
连接众测雷达
众测雷达交流群

交流跑题经验,参与雷达开发建设与领奖
官方公众号

官方唯一公众号 · 获取每日 AI 黄历
Join the Crowd Radar group chat
Discuss live benchmark results, model performance shifts, and what the community should test next.
参与贡献
右上角登录,用来确认身份、发一个访问令牌。不会碰你的 OpenAI 账号——订阅凭据全程留在你自己机器上,从不经过我们服务器。登录后默认用 GitHub 身份上榜:天梯和格子上显示你的 GitHub 用户名和头像,名字可点开你的 GitHub 主页;不想这样,就点右上角名字旁的「GitHub 身份」按钮切成「雷达身份」,改用雷达昵称和像素头像,积分和排名不变 —— 注意雷达昵称默认就取自你的 GitHub 用户名,切过去后点一下名字,不是你想公开的那个就改掉。
在表格上方的“我的 Codex 订阅类型”选择你的订阅档(Plus / 5x Pro / 20x Pro)——格子里的百分比是这道题大约占你选中档位 7 天额度的比例,同一道题对 Plus 可能是 6%,对 20x Pro 只有 0.3%。选对档位,看到的才是你的真实成本。
第一次来,建议先让 Codex 安装并检查环境,这一步不会占用任务格子,也不会启动正式跑题。全部检查通过后再选题,认领后的 20 分钟都能真正留给启动任务。
点表里可认领的格子勾选,单次最多 2 / 5 / 10 / 20 / 40 个(按月榜排名解锁),底部按“认领”;懒得挑就点“🚴 一键领题跑分”。20 分钟没开跑自动放回。
粘贴进你的 codex,它会自动配好环境、装好 dradar,把认领的题全部跑完——不用你敲一条命令。 高级玩法:直接问 Codex“dradar CLI 能做什么”,或让它“自动认领一批并跑完”“按本机配置并发跑已认领任务”“查看进度并补跑失败项”。不用背命令,描述目标就行。
你跑过的格子会点亮,名字也登上雷达天梯。发现问题或想改进?欢迎到 DRadar 开源仓库 ↗ 提交 Issue 或 PR,一起把雷达做得更好。
FAQ
测试的是什么题库?
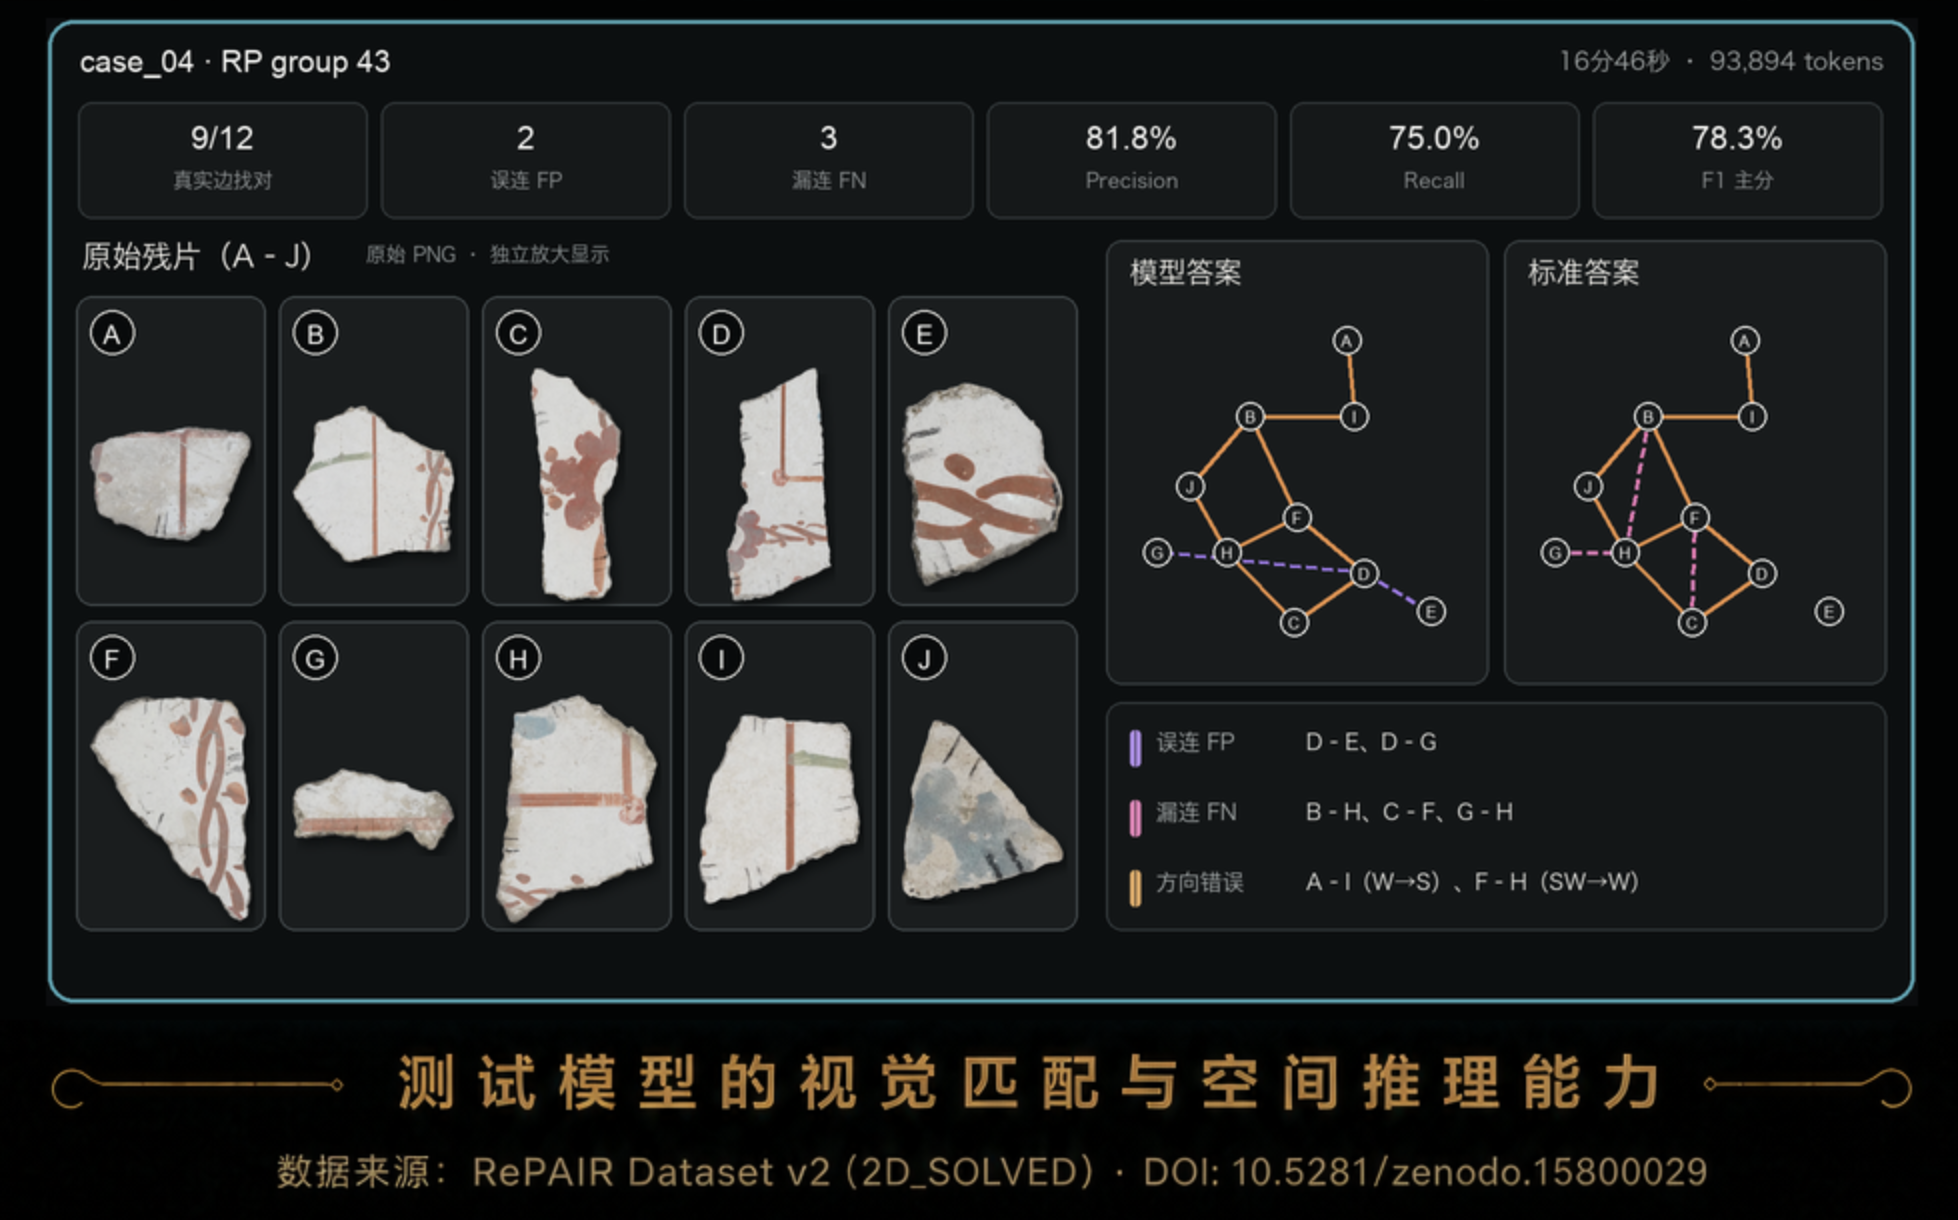
目前有两个独立频道:DeepSWE 测软件工程能力;庞贝壁画邻接恢复测试视觉推理能力,从 RePAIR 数据的 87 个独立 RP group 中留 1 个作公开示例,其余 86 个 group 各出 1 道正式题。两类成绩分开统计,不互相混分。
庞贝壁画邻接恢复怎么判分?
模型只需提交它判断存在的无向直接邻接边。隐藏评分器把预测边与该题标准邻接图逐条比较,计算 TP、FP、FN,再得出 Precision、Recall 和 F1;总榜主分是 86 题 Macro-F1,即每道题 F1 等权平均。绝对坐标、画布尺度、旋转、相对方向和最终拼图图像均不参与第一版判分。
百分比得分和 Codex 雷达的 IQ 分数怎么换算?
×1.5。DeepSWE 使用平均通过率,壁画频道使用平均邻接 F1;各自的百分比乘以 1.5,就是 Codex 雷达同尺度的恢复 IQ——满分对齐:100% = 150 分,0% = 0 分。例如平均 F1 为 86%,恢复 IQ 就是 129。
会支持其他 coding agent 和模型吗?
会。
Codex 对话里选择的模型会影响实际跑题模型吗?
不会。每个任务实际使用的模型和推理档位由 DRadar 在认领时明确指定,并在隔离的 Docker 环境中运行;外层 Codex 对话选择什么模型都不会替换任务配置。
“一键领取”只负责认领任务,不会自动开始跑题。领取后仍需复制运行提示词并启动 DRadar;如果任务没有完成,请检查 Docker、任务运行和环境检查状态,而不是更换外层对话模型。
会烧我多少额度?
额度是你自己的,dradar 不替你管、也不读取普通志愿者账号的余量。Codex 已取消 5 小时滚动限制,现在只有7 天额度一道约束,表里的价签全部按周额度换算——大多数题只占你周额度的百分之几,比 5h 时代宽裕约 6 倍。价签按你的订阅档估算(用上方档位切换),认领时量力而行即可。万一跑到一半撞上额度墙,任务会直接失败、格子自动放回给别人——不会白占着,也不会偷偷替你等额度刷新。价签由历史实测 + 志愿者数据每 15 分钟自动校准;档位总容量由站方超级账号在真实任务前后通过 Codex app-server 测量,累计实耗至少 $50 才会生成候选值,并且必须经过人工确认才会更新。
DeepSeek 格子不使用订阅额度,而是你自己的 API 余额。北京时间工作日 09:00–12:00、14:00–18:00 为高峰价,其余时间及周六、周日全天为低谷价;页面刷新时自动选择当前价段,也可用按钮手动切换本页价签预览,实际 API 等价费用仍按每次请求发生时的价段分别核算。
GLM-5.3 与 GLM-5.3 Flash 统一使用当前官方标准 API 单价折算 API 等价成本,成本本身不套用 Coding Plan 的峰谷优惠或其他订阅折扣。模型卡片只统计请求账本完整的运行,并按当前标准 API 单价重算其历史 token 用量;历史已结算积分保持不变。
模型卡片上的美元参考价按哪个额度算?不按任何订阅档位算。订阅档位(Plus / 5x Pro / 20x Pro)只决定题目表里“这道题占你周额度百分之几”,不影响任何美元数字。卡片上的价格是 API 等价成本:服务端按每次运行的真实 token 用量和官网标准 API 单价折算,每道题取最近 3 次有效运行,再把所有题目合起来取中位数。2026-09-20 起由平均改为中位数,两个站从此用同一个数,一次特别贵的运行不会再把整档的价抬上去。服务端证据不足的档位显示“–”,不拿估价顶替;你在页面上筛选题目时,卡片会按所选题目另算一个中位数,并在价格下面标出来。这个价不代表订阅服务商真的扣了这么多钱。
那价段按钮管谁?只管 DeepSeek 和 DSH——只有这两家有低谷价和高峰价两档,切换价段会用所选价段重算同一批真实 token。其余模型没有价段之分,包括 Codex 原生 GPT 各档、Claude、Kimi、ZCode、Grok、Antigravity 和 CodeBuddy。
积分怎么算?
统一公式:贡献积分 = 基础分或可核验的 API 等价成本 × 基础倍率 × 荒地倍率。所有运行工具、所有题库都使用同一套格子语义;服务端在认领时锁定最终倍率,提交时不会变低。
基础倍率:Codex 原生 GPT 为 1×–2×;Codex DeepSeek API 与 DSH 均为 75×–150×;Kimi K3 为 10×–20×;ZCode GLM-5.3 为 5×–10×;ZCode GLM-5.3 Flash 为 10×–20×;Grok 4.6 与 Antigravity Gemini 3.7 / 3.8 Flash 均为 3×–6×;CodeBuddy HY4 Preview 为 5×–10×。区间内倍率随格子空闲时间逐档提高。
荒地倍率:精确到“题目 × 运行工具/模型 × 推理档位”的格子。只要从未产生过有效且干净的判分记录,就是荒地,最终倍率额外乘固定 1.5×,格子上会直接显示“荒地 1.5×”。第一次有效判分完成后,无论通过还是未通过,都永久退出荒地;异常、无效、待复核记录不算。
荒地满倍率示例:Codex 原生 GPT 为 3×;Codex DeepSeek API 与 DSH 为 225×;Kimi K3 与 ZCode GLM-5.3 Flash 为 30×;ZCode GLM-5.3 与 CodeBuddy HY4 Preview 为 15×;Grok 4.6 与 Antigravity Gemini 3.7 / 3.8 Flash 为 9×。
成本口径:DeepSeek 按每条请求发生时的官网峰价或谷价复算实际成本;Kimi、ZCode、Grok、Antigravity 与 CodeBuddy 按完整请求账本和官网标准 API 单价折算 API 等价成本。输入缓存与 thinking token 均按各服务商账本语义去重,绝不重复计算;CodeBuddy 请求账本不完整时只显示“–”且不结算,其他证据不足的旧口径会明确显示“兜底估价”或不结算,绝不把估价冒充实耗。
历史已结算积分不追溯重算;目前不设其他临时倍率奖励。
连续贡献奖励:每天按北京时间完成至少一道有效判分任务得 5 分;连续 3 / 7 / 14 / 30 天再得 5 / 15 / 30 / 60 分。同一天多跑不重复领取,断签后开始新一轮。
天梯排名怎样影响并发和领题数?
每天认领数量不限。并发上限和单次领题数按当前月榜排名逐步解锁:第 1–5 名为 40 并发 / 一次 40 题,第 6–10 名为 20 并发 / 一次 20 题,第 11–20 名为 10 并发 / 一次 10 题,第 21–50 名为 5 并发 / 一次 5 题,第 51 名以后及尚未上榜的新手为 2 并发 / 一次 2 题。跑完腾出位子就能继续领;排名变化后自动按新档位生效。
自行车和蹬踏时间怎么算?
开始真实跑题就会显示自行车;同时有几路题目正在运行且状态正常,就依次显示几辆自行车和对应路数,约 15 秒刷新。最后一次有效跑题或提交后的 20 分钟内继续显示:前 10 分钟为“正在擦车”,后 10 分钟为“已停车”;期间接着跑会续在同一轮,超过 20 分钟才下掉并在下次重新计轮。蹬踏时间只算实际跑题时间,排队、换题、断线和留榜宽限不计时,并发重叠只算一次。
可以并行跑题吗?
可以——并发上限与当前月榜档位一致:第 1–5 名为 40,第 6–10 名为 20,第 11–20 名为 10,第 21–50 名为 5,第 51 名以后及尚未上榜的新手为 2。新手默认 1 车;Mac mini M4(16GB 内存)最多可同时运行 10 车。如果你有高性能服务器,并且排名已经解锁,可以挑战 40 车。车数是同一账号在所有设备上的总并发上限。
数据安全吗?
每道题都在独立、一次性的 Docker 容器里跑和判分,测完即销毁,跟别的题、别人的环境互不串扰。上传前后两道敏感信息扫描,带密钥的补丁直接拒收;凭据文件从不上传。补丁和运行轨迹只进服务端判分与审计,不出现在公开页面和公开接口里。
公开身份:登录后默认用你的 GitHub 用户名和头像,天梯上的名字直接链到你的 GitHub 主页;右上角名字旁的按钮可随时切成「雷达身份」,头像换成像素头像、名字不再链到 GitHub,积分和排名不变;切换后最多 5 分钟对所有访客完全生效(大表的格子有边缘缓存)。要紧的一点:雷达昵称是你用 GitHub 注册时自动取的,默认就是你的 GitHub 用户名,不是你自己起的。切过去之后点一下自己的名字,不是你想公开的那个就改掉。
公开统计:天梯的公开数据里,关于你的数字是全部公开的 —— 积分和排名、提交与判分题数、token 合计、成本合计、连续贡献天数,还有你在每一路模型上各拿了多少分、DeepSeek API 跑了多少次花了多少钱;正在跑题时,连你用的是哪种接入方式也在里面。
公开判分结果:每道题公开你跑了哪个模型和推理档位、过没过、用时和成本,以及这一次是怎么计分、怎么计价的,没通过的也在内;正在跑和排队判分的格子同样显示是谁在跑。你正在跑题时还会公开:现在开着几辆车、在跑哪一路模型、已经蹬了多久。
分数怎么保证真实?
客户端自报的结果一概不算数:每个补丁都在服务端的干净容器里重跑验证器打分。另有任务持有时间差、轨迹审计等多层检测,可疑提交先冻结——积分暂扣、不上榜、不计晋升,人工复核后:误伤的原数奉还(分一分不少),坐实的清零封号。
