FAQ
测试的是什么题库?
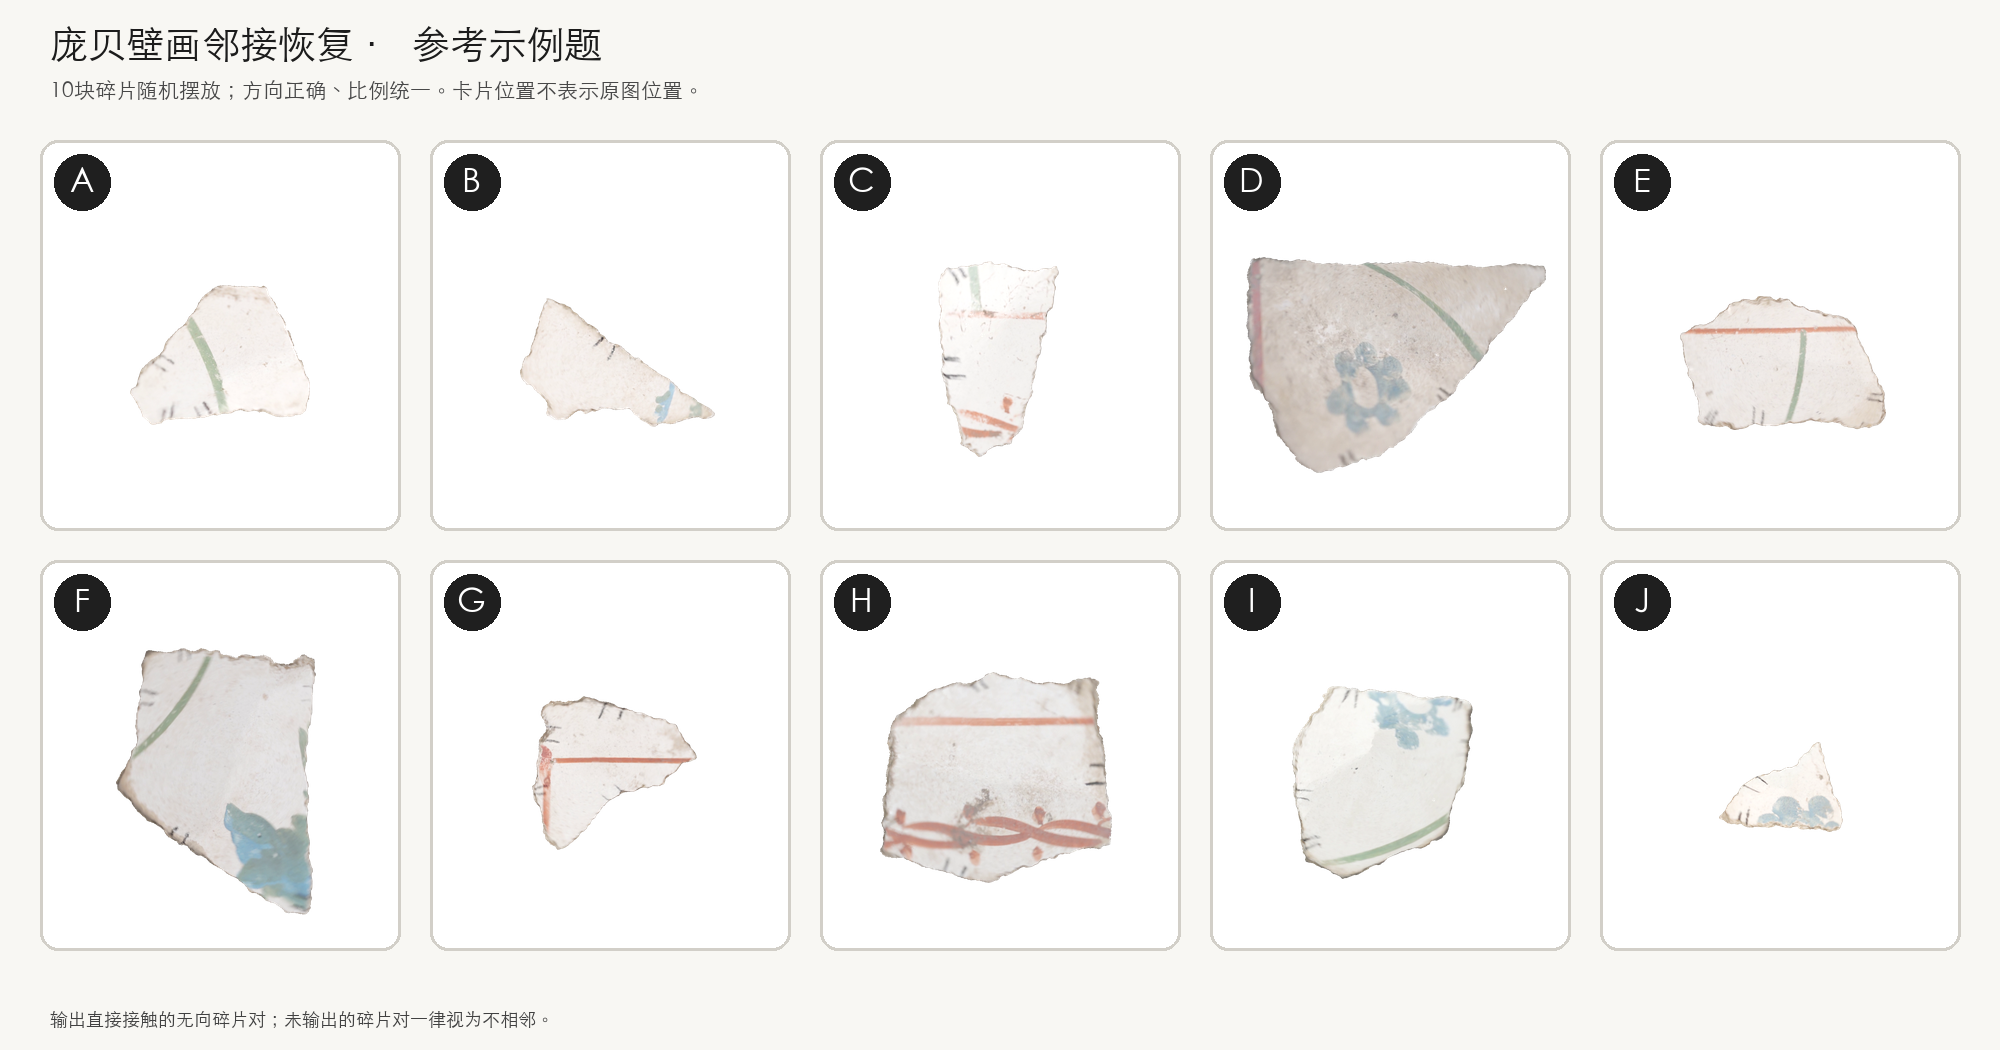
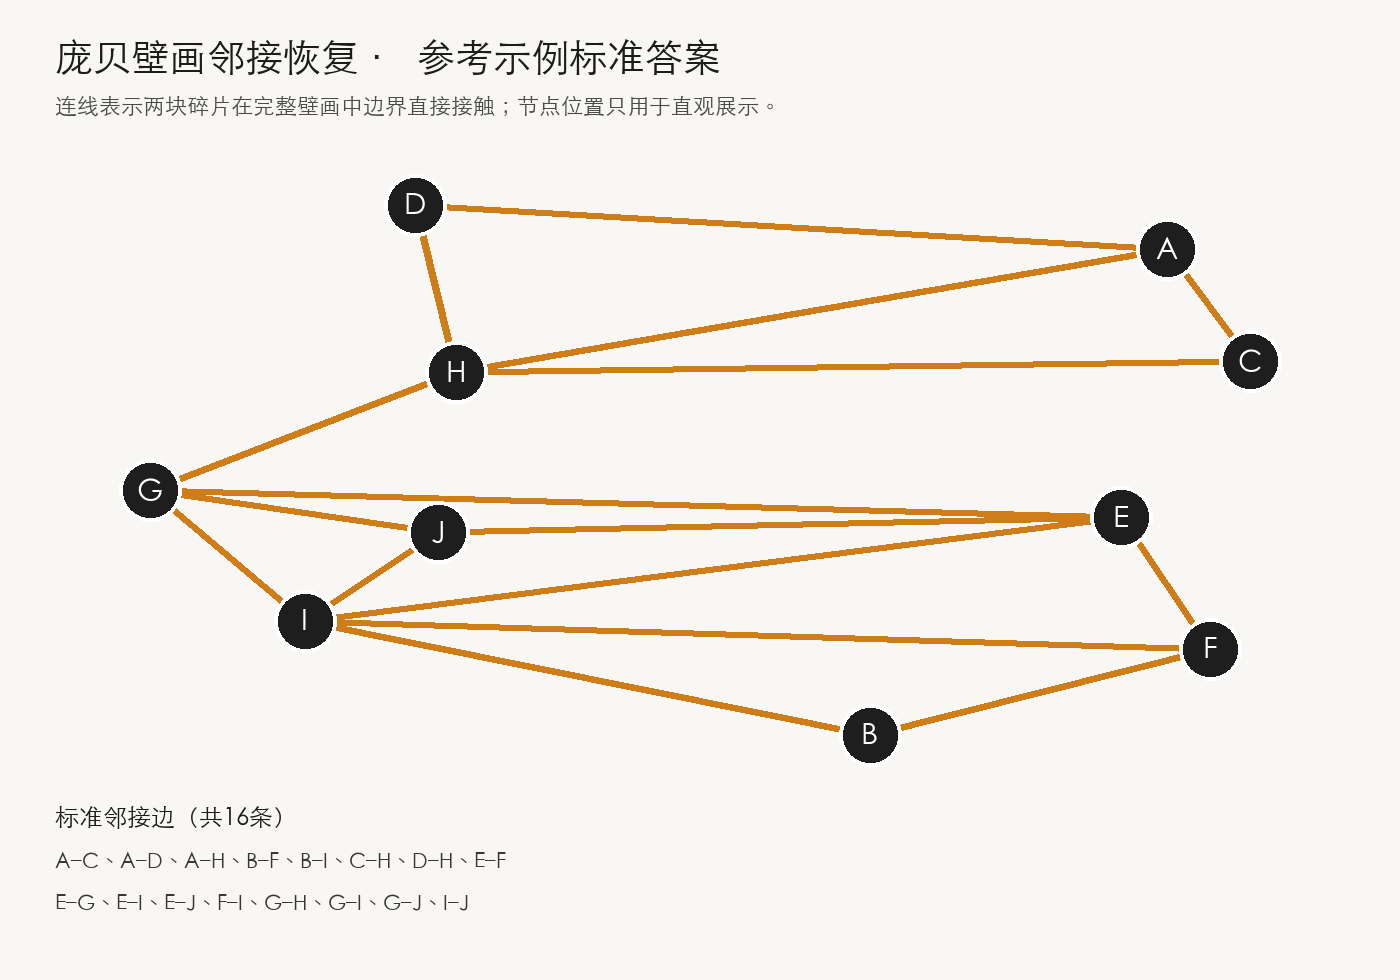
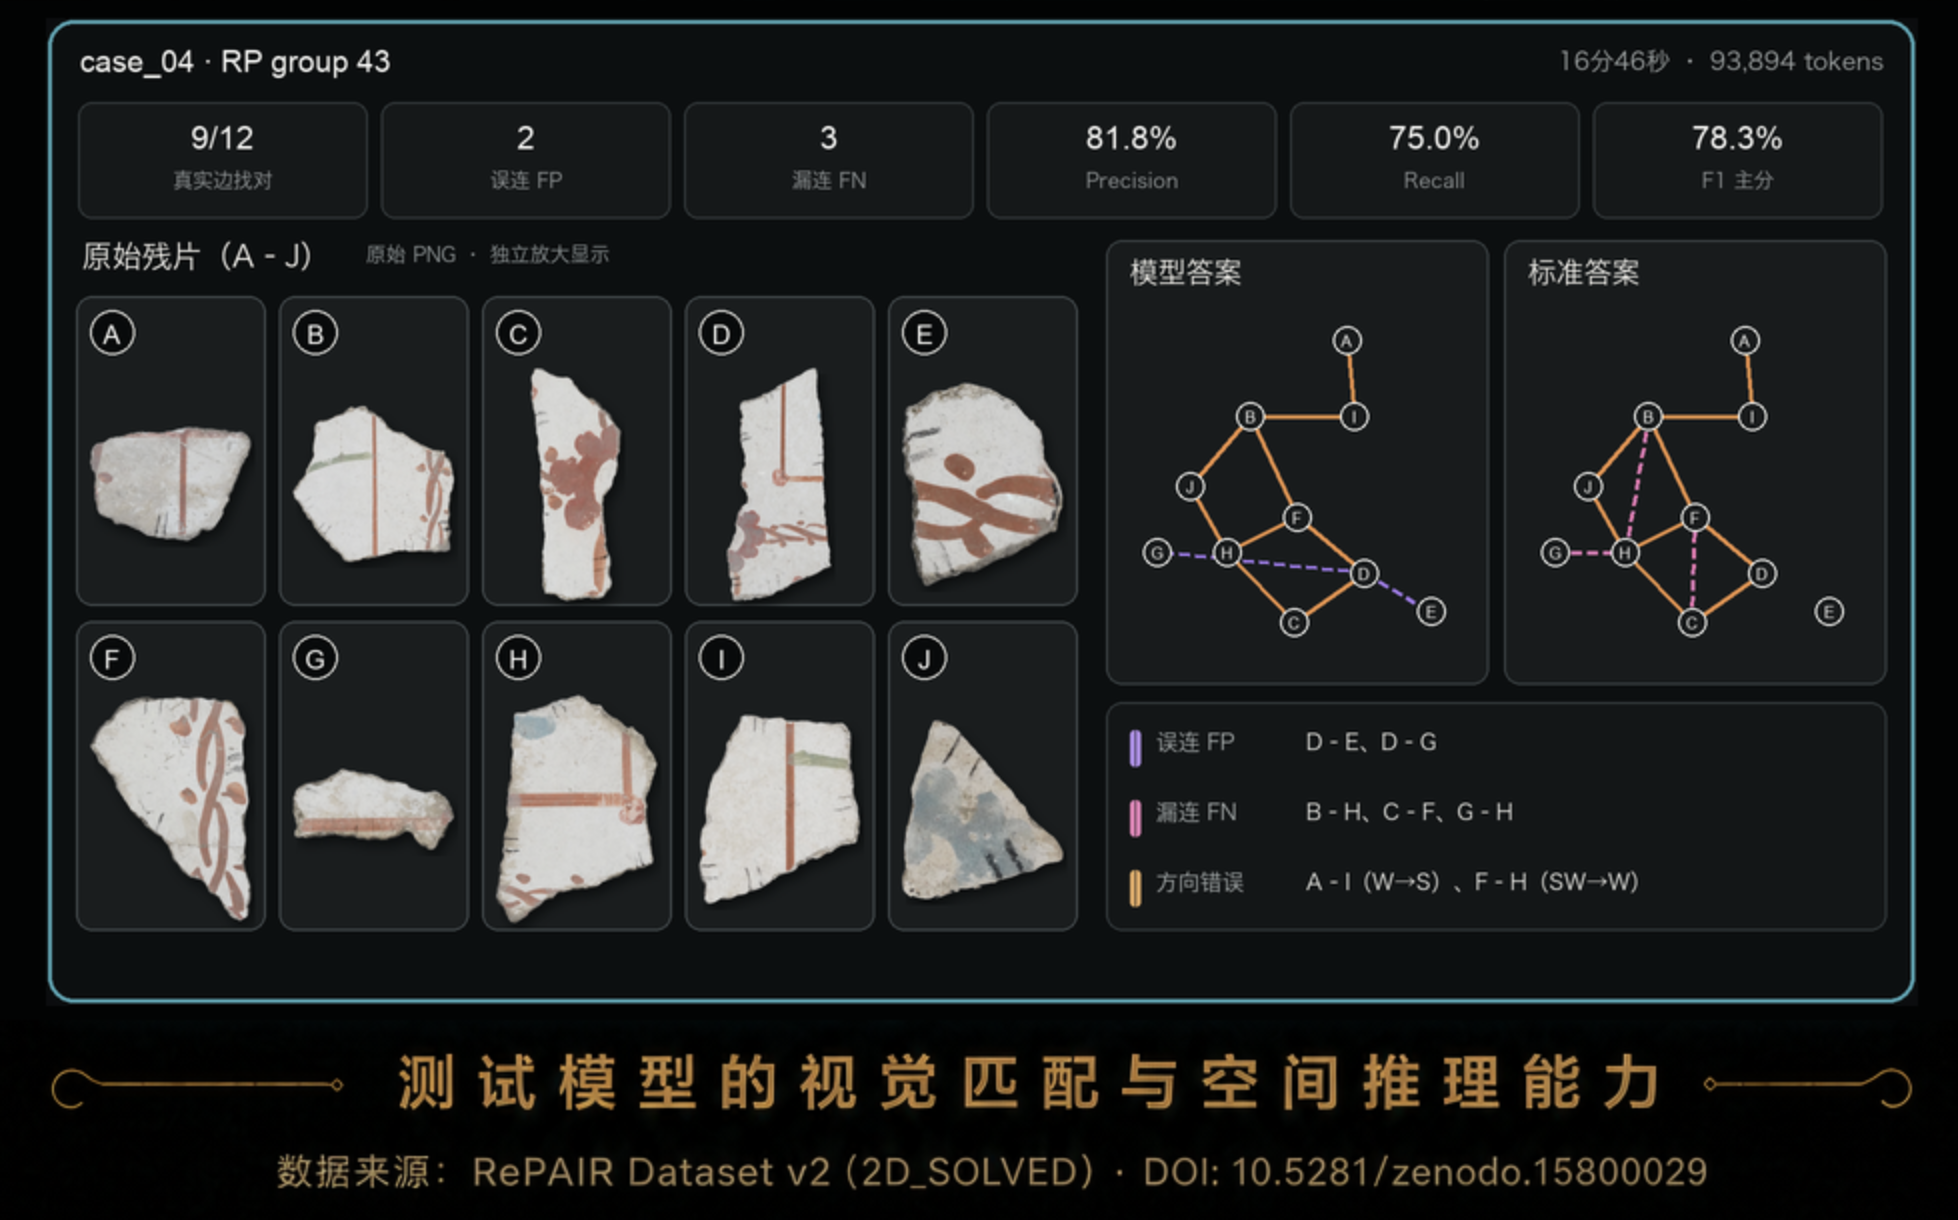
雷达Bench统一包含64题:DeepSWE 15题、庞贝16题、TB 14题、Science 19题,每题保留原环境和判分。v1总分按每题最近最多3次有效判分的均值,再对已覆盖题等权汇总为百分制,最终成绩 ×1.5(满分150分);覆盖不足64题为暂定分,未跑和待判不计0。总分、覆盖与趋势来自服务端权威成绩接口;缺少有效判分时显示暂无成绩,混合跑题是否开放以正式发行与实际能力核验为准。旧全库和原始历史继续留存;原 DeepSWE 测软件工程能力;庞贝壁画邻接恢复测试视觉推理能力,从 RePAIR 数据的 87 个独立 RP group 中留 1 个作公开示例,其余 86 个 group 各出 1 道正式题。两类成绩分开统计,不互相混分。
庞贝壁画邻接恢复怎么判分?
模型只需提交它判断存在的无向直接邻接边。隐藏评分器把预测边与该题标准邻接图逐条比较,计算 TP、FP、FN,再得出 Precision、Recall 和 F1;原全库入口的主分是 86 题 Macro-F1;新版精选入口只计算选定的 16 题,即每道题 F1 等权平均。绝对坐标、画布尺度、旋转、相对方向和最终拼图图像均不参与第一版判分。
雷达分如何计算?
雷达分先对每道题最近最多 3 次有效判分求平均,再对已覆盖题等权汇总为百分制最终成绩,最后 ×1.5(满分150分)。未覆盖题不计0,正式判分为0的样本正常计入;覆盖不足64题时为阶段分。分数、覆盖和近期判分均来自服务端,原始 reward 与运行统计保持不变,页面不重算总分。
会支持其他 coding agent 和模型吗?
首期按需运行仅接入 Codex;其他运行工具正在维护升级,现有成绩和历史继续保留浏览。
Codex 可以搭配 DeepSeek 吗?
不支持。Codex 使用正式 CLI/Server 已允许的模型和档位;DeepSeek 的 DSH 组合保持独立。旧 Codex×DeepSeek 原始记录与账本留存,但不进入当前模型卡片、题格、默认天梯和统计。DeepSWE 是题库,继续保留。
Codex 对话里选择的模型会影响实际跑题模型吗?
不会。每个任务实际使用的模型和推理档位由 DRadar 在认领时明确指定,并在隔离的 Docker 环境中运行;外层 Codex 对话选择什么模型都不会替换任务配置。
“开始雷达Bench”提供本地启动说明,网页不创建运行、不领取题目。准备好的空槽才由本地 CLI 按需领题,取得开始收据后执行;如果任务没有完成,请检查 Docker、任务运行和环境检查状态,而不是更换外层对话模型。
会烧我多少额度?
额度是你自己的,dradar 不替你管、也不读取普通志愿者账号的余量。Codex 已取消 5 小时滚动限制,现在只有7 天额度一道约束,表里的价签全部按周额度换算——大多数题只占你周额度的百分之几,比 5h 时代宽裕约 6 倍。价签按你的订阅档估算(用上方档位切换),认领时量力而行即可。遇到额度耗尽或上游异常时,保留原运行和成果;执行、退出或上传未知须先对账,不能把未知状态当作可重跑或已释放。价签由历史实测 + 志愿者数据每 15 分钟自动校准;档位总容量由站方超级账号在真实任务前后通过 Codex app-server 测量,累计实耗至少 $50 才会生成候选值,并且必须经过人工确认才会更新。
DSH 的 DeepSeek 格子不使用订阅额度,而是你自己的 API 余额。北京时间工作日 09:00–12:00、14:00–18:00 为高峰价,其余时间及周六、周日全天为低谷价;页面刷新时自动选择当前价段,也可用按钮手动切换本页价签预览,实际 API 等价费用仍按每次请求发生时的价段分别核算。
GLM-5.3 与 GLM-5.3 Flash 统一使用当前官方标准 API 单价折算 API 等价成本,成本本身不套用 Coding Plan 的峰谷优惠或其他订阅折扣。模型卡片只统计请求账本完整的运行,并按当前标准 API 单价重算其历史 token 用量;历史已结算积分保持不变。
模型卡片上的美元参考价按哪个额度算?不按任何订阅档位算。订阅档位(Plus / 5x Pro / 20x Pro)只决定题目表里“这道题占你周额度百分之几”,不影响任何美元数字。卡片上的价格是 API 等价成本:服务端按每次运行的真实 token 用量和官网标准 API 单价折算,每道题取最近 3 次有效运行,再把所有题目合起来取中位数。2026-09-20 起由平均改为中位数,两个站从此用同一个数,一次特别贵的运行不会再把整档的价抬上去。服务端证据不足的档位显示“–”,不拿估价顶替;你在页面上筛选题目时,卡片会按所选题目另算一个中位数,并在价格下面标出来。这个价不代表订阅服务商真的扣了这么多钱。
那价段按钮管谁?只管 DeepSeek 和 DSH——只有这两家有低谷价和高峰价两档,切换价段会用所选价段重算同一批真实 token。其余模型没有价段之分,包括 Codex 原生 GPT 各档、Claude、Kimi、ZCode、Grok、Antigravity 和 CodeBuddy。
积分怎么算?
统一公式:贡献积分 = 基础分或可核验的 API 等价成本 × 基础倍率 × 荒地倍率。所有运行工具、所有题库都使用同一套格子语义;服务端在认领时锁定最终倍率,提交时不会变低。
基础倍率:Codex 原生 GPT 为 1×–2×;Codex DeepSeek API 与 DSH 均为 75×–150×;Kimi K3 为 10×–20×;ZCode GLM-5.3 为 5×–10×;ZCode GLM-5.3 Flash 为 10×–20×;Grok 4.6 / 4.7 与 Antigravity Gemini 3.7 / 3.8 Flash 均为 3×–6×;CodeBuddy HY4 Preview 为 5×–10×。区间内倍率随格子空闲时间逐档提高。
荒地倍率:精确到“题目 × 运行工具/模型 × 推理档位”的格子。只要从未产生过有效且干净的判分记录,就是荒地,最终倍率额外乘固定 1.5×,格子上会直接显示“荒地 1.5×”。第一次有效判分完成后,无论通过还是未通过,都永久退出荒地;异常、无效、待复核记录不算。
荒地满倍率示例:Codex 原生 GPT 为 3×;Codex DeepSeek API 与 DSH 为 225×;Kimi K3 与 ZCode GLM-5.3 Flash 为 30×;ZCode GLM-5.3 与 CodeBuddy HY4 Preview 为 15×;Grok 4.6 / 4.7 与 Antigravity Gemini 3.7 / 3.8 Flash 为 9×。
成本口径:DeepSeek 按每条请求发生时的官网峰价或谷价复算实际成本;Kimi、ZCode、Grok、Antigravity 与 CodeBuddy 按完整请求账本和官网标准 API 单价折算 API 等价成本。输入缓存与 thinking token 均按各服务商账本语义去重,绝不重复计算;CodeBuddy 请求账本不完整时只显示“–”且不结算,其他证据不足的旧口径会明确显示“兜底估价”或不结算,绝不把估价冒充实耗。
Grok 4.6 公开对比使用按该模型发布时官方标准 API 价校正的 API 等价成本;部分早期原记录曾误用旧算法。原记录值和已结算积分保留,不代表订阅实际扣费。缺少完整、经验证的请求账本时不生成校正值。
历史已结算积分不追溯重算;目前不设其他临时倍率奖励。
连续贡献奖励:每天按北京时间完成至少一道有效判分任务得 5 分;连续 3 / 7 / 14 / 30 天再得 5 / 15 / 30 / 60 分。同一天多跑不重复领取,断签后开始新一轮。
天梯排名怎样影响并发和领题数?
本地用文字选择本次总题数和并发。CLI 在领取前核验当前服务端限制,不沿用网页旧批量上限,也不静默缩减配置;无需先点选题格:系统按所选题库和合法模型档位分配,网页本身不预留任务。开始过的失败、中断和不确定尝试仍计入本次总量,无题时报告实际短缺。
自行车和蹬踏时间怎么算?
开始真实跑题就会显示自行车;同时有几路题目正在运行且状态正常,就依次显示几辆自行车和对应路数,约 15 秒刷新。最后一次有效跑题或提交后的 20 分钟内继续显示:前 10 分钟为“正在擦车”,后 10 分钟为“已停车”;期间接着跑会续在同一轮,超过 20 分钟才下掉并在下次重新计轮。蹬踏时间只算实际跑题时间,排队、换题、断线和留榜宽限不计时,并发重叠只算一次。
题目如何分配,可以继续跑已做过的题吗?
无需点选题格。系统在同一有效运行工具、模型与题库范围,优先分配未跑过的“荒地”,再优先分配少跑的题目,使覆盖和次数均衡。全部跑过后仍可继续;历史、重复尝试和冷却时间不构成拒领理由,在途数量只用于轻量分散。维护、所有权、幂等和真实环境安全约束保留,重跑不重复结算同一成果。题格继续展示已跑次数、最近三次红绿状态与悬停近期结果。
可以并行跑题吗?
可以。并发由本地 CLI 按当前服务端能力和账号限制核验,在运行前回显你的选择。每个准备好的空槽最多领一道题;确认原进程退出并保存、接收成果后,才复用该槽。不同设备各自运行,不接管其他设备的任务。
数据安全吗?
每道题都在独立、一次性的 Docker 容器里跑和判分,测完即销毁,跟别的题、别人的环境互不串扰。上传前后两道敏感信息扫描,带密钥的补丁直接拒收;凭据文件从不上传。补丁和运行轨迹只进服务端判分与审计,不出现在公开页面和公开接口里。
公开身份:登录后默认用你的 GitHub 用户名和头像,天梯上的名字直接链到你的 GitHub 主页;右上角名字旁的按钮可随时切成「雷达身份」,头像换成像素头像、名字不再链到 GitHub,积分和排名不变;切换后最多 5 分钟对所有访客完全生效(大表的格子有边缘缓存)。要紧的一点:雷达昵称是你用 GitHub 注册时自动取的,默认就是你的 GitHub 用户名,不是你自己起的。切过去之后点一下自己的名字,不是你想公开的那个就改掉。
公开统计:天梯的公开数据里,关于你在现行展示范围内的数字是公开的 —— 积分和排名、提交与判分题数、token 合计、成本合计、连续贡献天数,还有你在每一路模型上各拿了多少分、DeepSeek API 跑了多少次花了多少钱;正在跑题时,连你用的是哪种接入方式也在里面。
公开判分结果:每道题公开你跑了哪个模型和推理档位、过没过、用时和成本,以及这一次是怎么计分、怎么计价的,没通过的也在内;正在跑和排队判分的格子同样显示是谁在跑。你正在跑题时还会公开:现在开着几辆车、在跑哪一路模型、已经蹬了多久。
分数怎么保证真实?
客户端自报的结果一概不算数:每个补丁都在服务端的干净容器里重跑验证器打分。另有任务持有时间差、轨迹审计等多层检测,可疑提交先冻结——积分暂扣、不上榜、不计晋升,人工复核后:误伤的原数奉还(分一分不少),坐实的清零封号。